Thème : SRE : fiabilité & performance
Observabilité MELT : quatre signaux, une stack Grafana
Métriques, événements, journaux et traces répondent chacun à une question différente. Cet article les distingue, montre où la stack Grafana les range et comment passer de l'un à l'autre pendant un diagnostic.
En bref
À l'issue de cet article, vous saurez :
- distinguer les quatre signaux MELT et la question à laquelle chacun répond ;
- associer chaque signal au composant de la stack Grafana qui le collecte, le stocke ou l'affiche ;
- corréler les signaux entre eux : d'une alerte à la trace, puis au journal ;
- choisir quoi instrumenter en premier selon votre contexte.
Pour aller vite :
- Les métriques disent que quelque chose ne va pas, les traces où, les journaux pourquoi ; les événements disent ce qui a changé.
- La valeur vient de la corrélation : un même
trace_idet un mêmeservice.namedans tous les signaux. - Un seul collecteur pour tous les signaux (Alloy, ou l'OpenTelemetry Collector), plutôt qu'un agent par outil.
Contexte
Une alerte de SLO se déclenche sur le service de paiement. L'équipe confirme la hausse des erreurs dans les métriques, cherche dans les journaux sans savoir quel service interroger, puis ouvre l'outil de traces, où rien ne relie une requête en erreur à ses journaux. Trois outils, trois requêtes, une heure de diagnostic, pour une cause qui tenait en une ligne de journal.
Ce n'est pas un manque de données, c'est un manque de liens. MELT (Metrics, Events, Logs, Traces) nomme les quatre signaux d'une observabilité complète ; leur intérêt tient surtout à la possibilité de passer de l'un à l'autre. OpenTelemetry fournit le format commun de collecte, et la stack open source de Grafana Labs un stockage par signal avec une interface unique pour les corréler. C'est elle qui illustre cet article ; les concepts valent pour d'autres outils.
Concepts clés
Métriques
Des valeurs agrégées dans le temps (compteurs, jauges, histogrammes), identifiées par un nom et des étiquettes ; Prometheus ou Mimir les stockent, PromQL les interroge. Agrégées dès la source, elles ne gardent pas le détail de chaque requête, et n'en ont pas besoin pour donner l'alerte. Signal le moins coûteux et le plus rapide, elles portent les SLO, les alertes et les tableaux de bord.
Événements
Un fait ponctuel qui modifie le système : déploiement, changement de configuration, bascule, début d'incident. Rare, il décrit un changement, là où le journal décrit un fonctionnement. Dans Grafana, il devient une annotation, un trait vertical sur tous les graphiques, alimentée par l'API HTTP ou une requête sur Loki. Une courbe qui plonge juste après ce trait oriente le diagnostic plus vite que n'importe quelle requête.
Journaux
Des enregistrements horodatés, de préférence structurés. Loki n'indexe que quelques étiquettes : LogQL sélectionne des flux, puis filtre leur contenu, ce qui n'a rien d'une recherche plein texte. Reçu en OTLP, service.name devient l'étiquette service_name, et les autres attributs, dont l'identifiant de trace, des métadonnées structurées filtrables sans être indexées. Peu d'étiquettes, donc, et le reste en métadonnées.
Traces
Une trace suit une requête à travers les services, découpée en spans (opération, durée, statut, attributs) reliés par un trace_id ; Tempo les stocke, TraceQL les interroge. Elle donne la structure, qui appelle qui et combien de temps, là où un journal ne donne que des événements isolés. Le générateur de métriques de Tempo en tire des métriques RED (taux, erreurs, durée) et une carte des dépendances, sans instrumentation supplémentaire.
Corrélation
Passer d'un signal à l'autre pour la même requête, le même service ou le même instant. Trois graphiques côte à côte sans identifiant commun ne sont pas corrélés. Un point d'un graphique PromQL porte un exemplar, l'identifiant d'une trace : un clic ouvre la trace dans Tempo, un autre ses journaux dans Loki. Trois conventions suffisent : le même service.name, le trace_id dans les journaux, les exemplars activés.
Collecteur unique
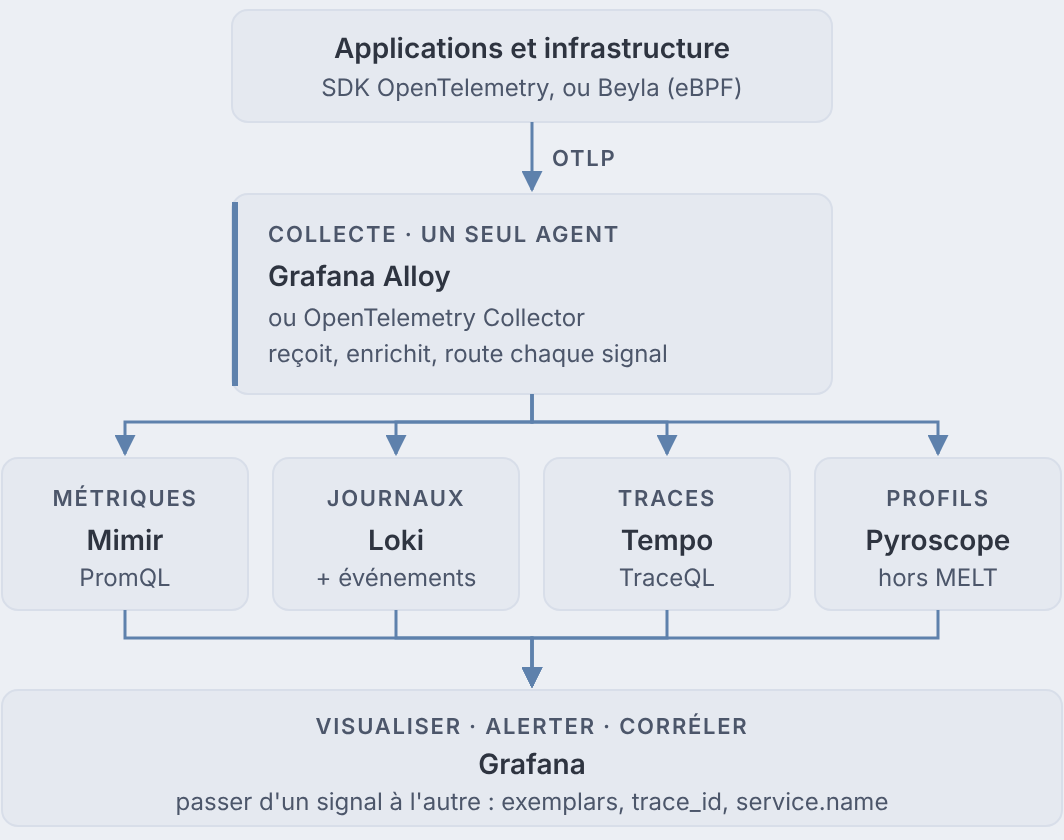
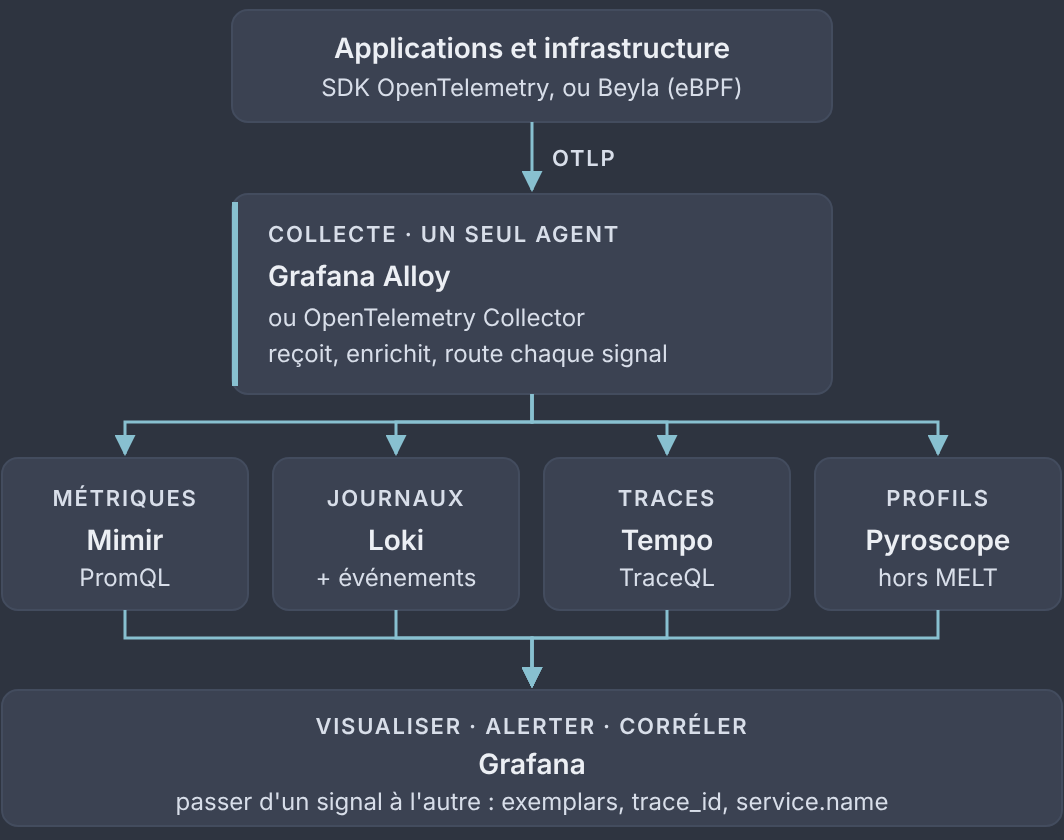
Un seul agent par nœud reçoit tous les signaux en OTLP, les enrichit, les échantillonne et les route. Côté Grafana, c'est Alloy, une distribution du collecteur OpenTelemetry qui exécute aussi des pipelines Prometheus. L'OpenTelemetry Collector, neutre vis-à-vis des éditeurs, peut le remplacer sans toucher aux stockages, qui acceptent l'OTLP. Le collecteur transporte ; l'instrumentation (SDK OpenTelemetry, ou Beyla par eBPF pour les services qu'on ne peut pas modifier) produit les signaux.
Cardinalité
Le nombre de combinaisons distinctes d'étiquettes, chacune devenant une série dans Mimir ou un flux dans Loki. Ce n'est pas le volume : dix étiquettes à deux valeurs coûtent moins qu'une seule à un million de valeurs. Un identifiant d'utilisateur en étiquette crée une série par utilisateur. Identifiants de requête, d'utilisateur ou de commande vont dans les traces ou les métadonnées, jamais en étiquettes.
Référence rapide
Un signal, un composant
| Signal | Stockage | Langage de requête | Question typique |
|---|---|---|---|
| Métriques | Prometheus, Mimir | PromQL | Le taux d'erreurs dépasse-t-il le budget ? |
| Événements | Annotations Grafana, Loki | LogQL, API Grafana | Qu'a-t-on déployé juste avant ? |
| Journaux | Loki | LogQL | Quel message accompagne cette erreur ? |
| Traces | Tempo | TraceQL | Quel appel porte la latence ? |
| Profils (hors MELT) | Pyroscope | — | Quelle fonction consomme le CPU ? |
Passer d'un signal à l'autre dans Grafana
| De | Vers | Mécanisme |
|---|---|---|
| Métriques | Traces | Exemplars de la source Prometheus, ouverts dans Tempo |
| Journaux | Traces | Champs dérivés (derived fields) de la source Loki, sur le trace_id |
| Traces | Journaux | Réglage Trace to logs de la source Tempo |
| Traces | Métriques | Réglage Trace to metrics de la source Tempo |
| Traces | Profils | Réglage Trace to profiles de la source Tempo, vers Pyroscope |
Critère de décision
Quoi instrumenter en premier ? Les métriques des parcours qui portent vos SLO, puis les traces de ces mêmes parcours, puis le trace_id dans les journaux. Les événements de déploiement coûtent presque rien et se branchent dès le premier jour.
Collecte avec Alloy
Un pipeline minimal : réception OTLP, regroupement par lots, puis un stockage par signal. Les noms de composants, les ports par défaut (4317 en gRPC, 4318 en HTTP) et les points d'entrée de Mimir et Loki sont ceux de la documentation officielle ; les noms d'hôtes sont à adapter.
// Réception OTLP depuis les applications instrumentées
otelcol.receiver.otlp "default" {
  grpc {}
  http {}

  output {
    metrics = [otelcol.processor.batch.default.input]
    logs    = [otelcol.processor.batch.default.input]
    traces  = [otelcol.processor.batch.default.input]
  }
}

// Regroupement par lots avant envoi
otelcol.processor.batch "default" {
  output {
    metrics = [otelcol.exporter.prometheus.mimir.input]
    logs    = [otelcol.exporter.otlphttp.loki.input]
    traces  = [otelcol.exporter.otlphttp.tempo.input]
  }
}

// Métriques → Mimir, par le protocole remote write de Prometheus
otelcol.exporter.prometheus "mimir" {
  forward_to = [prometheus.remote_write.mimir.receiver]
}

prometheus.remote_write "mimir" {
  endpoint {
    url = "http://mimir:9009/api/v1/push"
  }
}

// Journaux → Loki, en OTLP natif
otelcol.exporter.otlphttp "loki" {
  client {
    endpoint = "http://loki:3100/otlp"
  }
}

// Traces → Tempo, en OTLP
otelcol.exporter.otlphttp "tempo" {
  client {
    endpoint = "http://tempo:4318"
  }
}
otelcol.exporter.prometheus convertit les métriques pour prometheus.remote_write, qui pousse vers /api/v1/push de Mimir ; l'exportateur otlphttp ajoute /v1/logs au point d'entrée /otlp de Loki. En production, ajoutez TLS et l'authentification de chaque stockage.
Alloy ou OpenTelemetry Collector
Les deux reçoivent l'OTLP et alimentent les mêmes stockages. La documentation d'OpenTelemetry range d'ailleurs Alloy parmi les distributions tierces de son collecteur, qu'elle précise ne pas valider.
| Critère | Grafana Alloy | OpenTelemetry Collector |
|---|---|---|
| Éditeur | Grafana Labs | Projet OpenTelemetry (CNCF), neutre vis-à-vis des éditeurs |
| Configuration | Syntaxe propre à Alloy, composants otelcol.* et prometheus.* |
YAML : receivers, processors, exporters, connectors, puis service.pipelines |
| Prometheus | Pipelines Prometheus natifs (collecte, réécriture d'étiquettes, remote write) | Par des composants de la distribution contrib |
| Distributions | Une seule, maintenue par Grafana Labs | Officielles : core, contrib, k8s, otlp ; ou la vôtre, assemblée avec l'outil ocb |
| Points d'écoute | Ceux de la configuration | localhost par défaut : l'exposer explicitement pour recevoir depuis d'autres hôtes |
| Quand le choisir | La stack Grafana est la cible, avec des pipelines Prometheus existants | Plusieurs backends ou éditeurs, ou une configuration à garder indépendante de l'éditeur |
Requêtes de diagnostic
# PromQL — part des requêtes en erreur, par service (métriques)
sum by (service_name) (rate(http_requests_total{code=~"5.."}[5m]))
/
sum by (service_name) (rate(http_requests_total[5m]))

# TraceQL — traces en erreur d'un service (traces)
{ resource.service.name = "checkout" && status = error }

# TraceQL — spans lents de ce service
{ resource.service.name = "checkout" && span:duration > 500ms }

# TraceQL metrics — taux d'erreurs calculé depuis les traces
100 * ({ status = error } | rate()) / ({ } | rate())

# LogQL — journaux d'une trace, par métadonnée structurée (journaux)
{service_name="checkout"} | trace_id="0242ac120002"
Les métriques HTTP prises en exemple viennent de votre instrumentation : adaptez le nom et les étiquettes à ce qu'elle expose.
Erreurs fréquentes
Les séries de métriques explosent
Symptôme. La mémoire de Prometheus ou la facture de Mimir grimpe sans hausse du trafic. Cause. Une étiquette à forte cardinalité (identifiant d'utilisateur, chemin d'URL avec identifiants). Correction. Retirez-la, normalisez les chemins (/orders/{id}) et portez le détail dans les traces.
Loki refuse des journaux
Symptôme. Des erreurs de limite de flux actifs, ou des requêtes lentes sur peu de données. Cause. Trop d'étiquettes, ou à trop de valeurs. Correction. Gardez en étiquettes le service, l'environnement et quelques dimensions stables ; le reste en métadonnées structurées.
Impossible de passer d'un journal à sa trace
Symptôme. Aucun lien vers Tempo depuis les journaux d'une requête en erreur. Cause. Pas de trace_id dans les journaux, ou pas de champ dérivé dans la source Loki. Correction. Émettez les journaux par le SDK OpenTelemetry, qui ajoute le contexte de trace, puis configurez le champ dérivé.
Une requête TraceQL ne renvoie rien
Symptôme. { span.http.response.status_code >= 500 } ne trouve rien, alors que des erreurs existent. Cause. Le nom de l'attribut dépend des conventions sémantiques suivies : http.status_code dans les anciennes, http.response.status_code dans les récentes. Correction. Vérifiez le nom dans une trace réelle, ou filtrez sur status = error.
Les traces d'erreurs manquent
Symptôme. Avec 1 % des traces conservées, les requêtes en erreur y figurent rarement. Cause. L'échantillonnage est décidé en tête de requête. Correction. Échantillonnez en fin de trace dans le collecteur (otelcol.processor.tail_sampling dans Alloy), en gardant erreurs et lenteurs.
Attention
L'échantillonnage en fin de trace exige que tous les spans d'une trace arrivent au même collecteur. Avec plusieurs instances d'Alloy, répartissez les spans par trace_id avant.
Aide-mémoire
- Métriques : que se passe-t-il ? Mimir, PromQL.
- Événements : qu'est-ce qui a changé ? Annotations Grafana.
- Journaux : pourquoi ? Loki, LogQL, peu d'étiquettes.
- Traces : où ? Tempo, TraceQL.
- Profils : quelle fonction ? Pyroscope, hors MELT.
- Collecte : un seul collecteur en OTLP, Alloy ou OpenTelemetry Collector.
- Corrélation : même
service.name,trace_iddans les journaux, exemplars activés. - Cardinalité : identifiants en traces ou métadonnées, jamais en étiquettes.
- Échantillonnage : en fin de trace, erreurs et lenteurs gardées.
Pour aller plus loin
- Objectifs de service et SRE en 2026, sur ce blog.
- Signaux OpenTelemetry et OpenTelemetry Collector (configuration, distributions).
- Grafana Alloy.
- Loki et OpenTelemetry, métadonnées structurées.
- Requêtes TraceQL et métriques issues des traces.
- Relier les traces aux autres signaux et exemplars.
Vos diagnostics passent par trois outils et une heure de recherche ? Construisons une observabilité qui relie vos signaux.