Thème : SRE : fiabilité & performance
Objectifs de service : les définir, les mesurer, s'en servir
Un objectif de service transforme « le service est-il fiable ? » en une question à laquelle on répond par un chiffre et une décision. Cet article définit SLI, SLO et budget d'erreur, montre comment les mesurer avec Prometheus et les relie aux métriques DORA.
En bref
À l'issue de cet article, vous saurez :
- distinguer SLI, SLO, SLA et budget d'erreur ;
- choisir les SLI d'un service à partir de ce que vivent ses utilisateurs ;
- calculer un budget d'erreur et son taux de consommation sur une fenêtre donnée ;
- mettre en place la mesure et une alerte sur la consommation du budget, avec Prometheus.
En résumé :
- Un SLO se mesure du point de vue de l'utilisateur, jamais de celui du serveur.
- Le budget d'erreur, c'est ce que le SLO autorise à rater : il se dépense en livraisons et en incidents.
- On alerte sur la vitesse de consommation du budget, pas sur un taux d'erreur instantané.
Contexte
« Quelle est notre fiabilité ? » La question arrive souvent après un incident, et les réponses habituelles n'aident pas : un taux de disponibilité des serveurs à 99,98 % alors que les utilisateurs ont vu des erreurs pendant une heure, ou une capture de tableau de bord que personne ne sait lire.
Les objectifs de service répondent à trois besoins : mesurer ce que vit l'utilisateur, et non l'état des machines ; fixer un niveau de fiabilité suffisant, et non maximal, car chaque neuf coûte en infrastructure, en astreinte et en vitesse de livraison ; arbitrer entre livrer et stabiliser à partir d'un chiffre partagé.
Ils complètent les métriques DORA, qui mesurent la performance de livraison : fréquence de déploiement, délai des changements, taux d'échec des changements, temps de rétablissement après un déploiement raté et, depuis 2024, taux de déploiements de reprise. DORA dit à quelle vitesse et avec quelle stabilité une équipe livre ; le SLO dit si ce qu'elle livre tient sa promesse. Une équipe peut livrer vite tout en épuisant son budget d'erreur : c'est ce que le SLO rend visible.
Concepts clés
SLI, l'indicateur
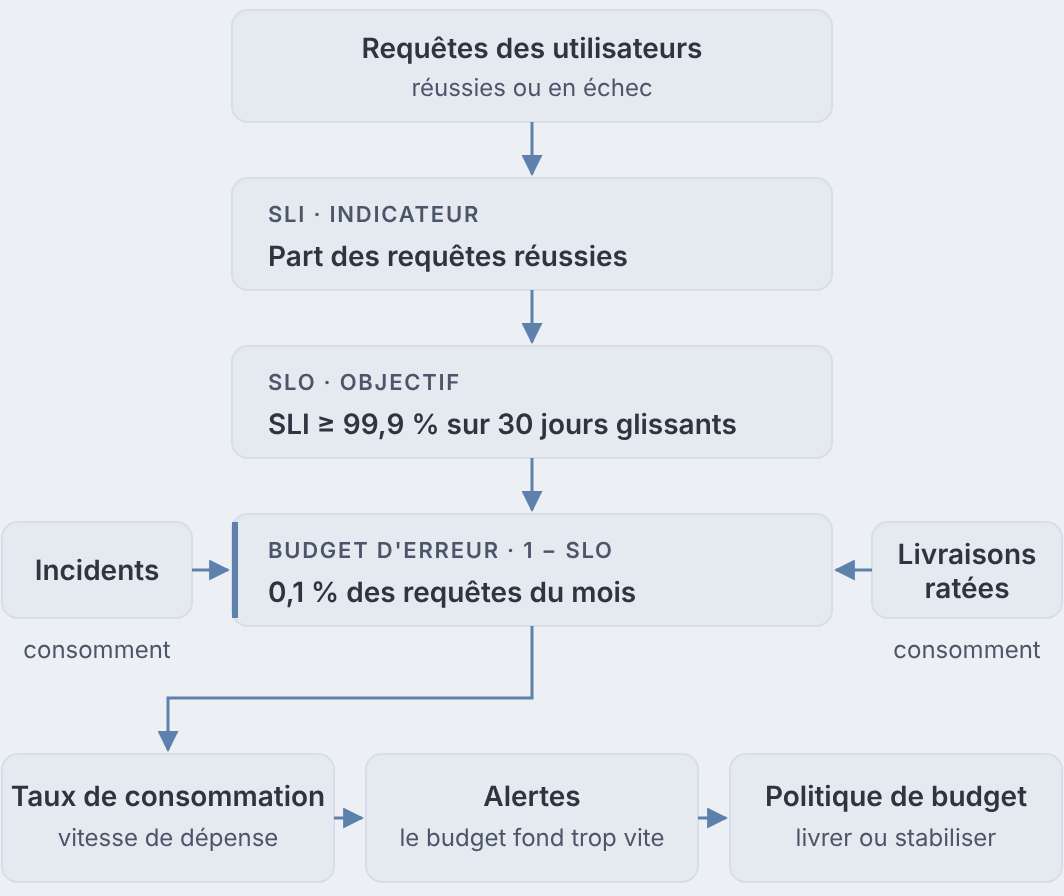
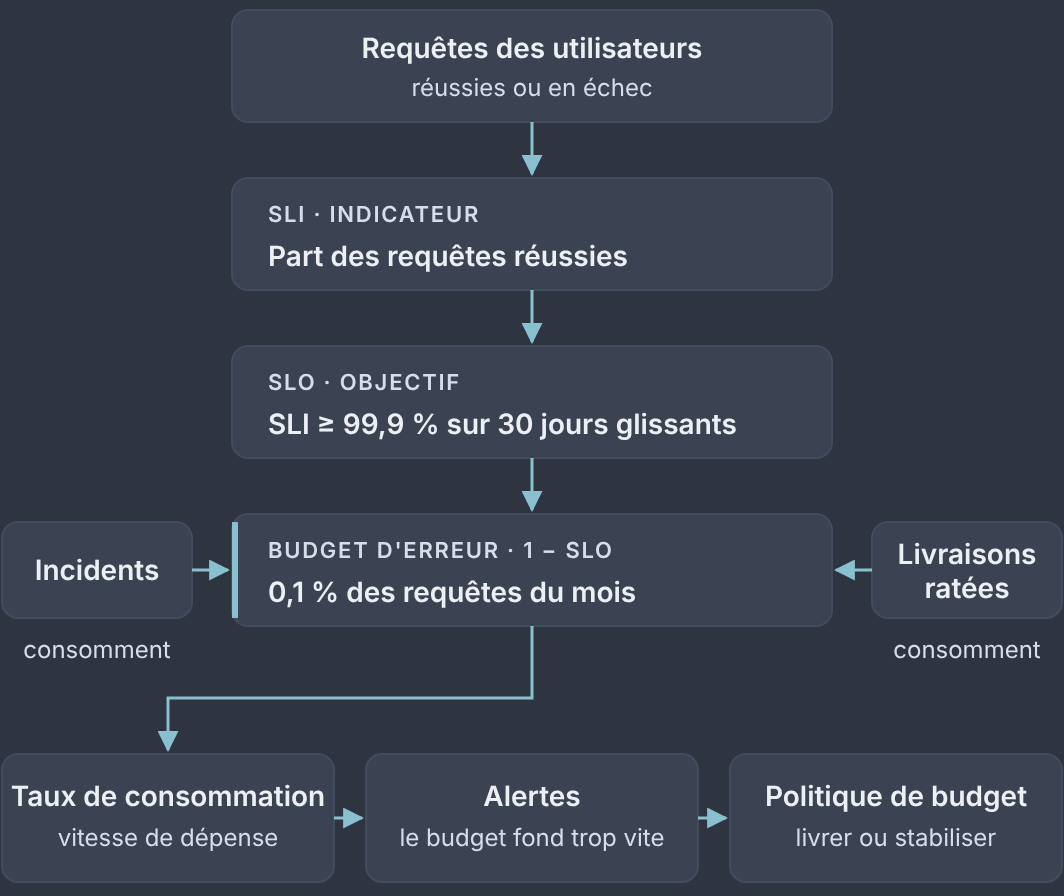
Un SLI est un ratio : événements « bons » sur événements valides, par exemple les requêtes sans erreur 5xx sur toutes les requêtes. Le CPU ou le nombre de pods n'en sont pas : ils expliquent une panne sans dire si l'utilisateur la subit. Le SRE Workbook classe les SLI par type de service : disponibilité, latence, qualité pour un service à requêtes ; fraîcheur, exactitude, couverture pour un traitement de données ; durabilité pour du stockage. Plus la mesure est proche de l'utilisateur (journaux applicatifs, répartiteur de charge, sonde externe, navigateur), plus le chiffre est honnête.
SLO, l'objectif
Le SLO est la cible fixée sur un SLI et une fenêtre : « 99,9 % de requêtes réussies sur 30 jours glissants ». Interne, il se distingue du SLA, engagement contractuel, et reste plus exigeant pour garder une marge. Le livre SRE déconseille de viser 100 % : au-delà d'un seuil, l'utilisateur ne voit plus la différence. Deux ou trois SLO par service suffisent, sur les parcours qui comptent.
Budget d'erreur
Le budget d'erreur vaut 1 − SLO : à 99,9 %, 0,1 % des requêtes du mois peuvent échouer. À 1 000 requêtes par minute, soit 43,2 millions en 30 jours, cela fait 43 200 échecs, ou environ 43 minutes d'indisponibilité totale. C'est une ressource à dépenser, en livraisons comme en incidents : tant qu'il en reste, on livre ; épuisé, la fiabilité passe en premier.
Fenêtre glissante ou calendaire
Une fenêtre glissante couvre les N derniers jours ; une fenêtre calendaire repart de zéro chaque mois. Avec la seconde, un incident du 30 est « oublié » le 1er ; avec la première, il pèse 30 jours. Le SRE Workbook recommande la fenêtre glissante, plus proche de la mémoire des utilisateurs, ce qui n'empêche pas de rendre compte au mois.
Taux de consommation
Le taux de consommation (burn rate) compare la vitesse de dépense du budget à celle qui l'épuiserait pile en fin de fenêtre : à 1, il dure 30 jours ; à 14,4, un peu plus de deux jours. Ce n'est pas le taux d'erreur : 2 % d'erreurs donnent un taux de 20 pour un SLO à 99,9 %, de 2 pour un SLO à 99 %. Une heure à 14,4 consomme 2 % du budget mensuel (14,4 ÷ 720 heures). C'est sur lui qu'on alerte.
Politique de budget d'erreur
Un document court, validé par le produit, le développement et l'exploitation, dit ce qui se passe quand le budget est épuisé : gel des fonctionnalités, priorité aux correctifs, post-mortem obligatoire au-delà d'un seuil. Ce n'est pas une sanction, mais la fin des arbitrages au cas par cas. Sans elle, un SLO reste un indicateur ; avec elle, il devient un outil de décision.
Référence rapide
SLO et métriques DORA
| Question | Répondue par | Exemple |
|---|---|---|
| Livrons-nous vite ? | DORA : fréquence de déploiement, délai des changements | Plusieurs déploiements par jour |
| Nos livraisons sont-elles stables ? | DORA : taux d'échec des changements, taux de déploiements de reprise | 5 % des déploiements demandent une intervention |
| Récupérons-nous vite d'un déploiement raté ? | DORA : temps de rétablissement après un déploiement raté | Retour arrière en 10 minutes |
| Les utilisateurs obtiennent-ils ce qui est promis ? | SLO et budget d'erreur | 99,9 % de requêtes réussies sur 30 jours |
| Pouvons-nous continuer à livrer à ce rythme ? | Budget d'erreur restant | Budget consommé à 40 % au 20e jour |
Choisir l'alerte (SLO de 99,9 % sur 30 jours)
Valeurs recommandées par le SRE Workbook (chapitre Alerting on SLOs) : une alerte se déclenche quand la fenêtre longue et une fenêtre courte, égale à un douzième de la longue, dépassent le seuil.
| Budget consommé | Fenêtre longue | Fenêtre courte | Taux de consommation | Seuil d'erreurs | Action |
|---|---|---|---|---|---|
| 2 % | 1 h | 5 min | 14,4 | 1,44 % | Réveiller l'astreinte |
| 5 % | 6 h | 30 min | 6 | 0,6 % | Réveiller l'astreinte |
| 10 % | 3 jours | 6 h | 1 | 0,1 % | Ticket |
Critère de décision
La fenêtre courte évite qu'une alerte reste active longtemps après la fin du problème : la fenêtre longue garde la mémoire d'un incident, la courte confirme qu'il est toujours en cours.
Mesure avec Prometheus
Un SLI de disponibilité (réponses non 5xx) pour un service api exposant http_requests_total. Règles validées par promtool check rules et un test unitaire (promtool 2.45).
groups:
  - name: slo-api-disponibilite
    rules:
      # SLI : part des requêtes en erreur (5xx), sur plusieurs fenêtres
      - record: job:slo_errors_per_request:ratio_rate5m
        expr: |
          sum by (job) (rate(http_requests_total{job="api", code=~"5.."}[5m]))
          /
          sum by (job) (rate(http_requests_total{job="api"}[5m]))
      - record: job:slo_errors_per_request:ratio_rate30m
        expr: |
          sum by (job) (rate(http_requests_total{job="api", code=~"5.."}[30m]))
          /
          sum by (job) (rate(http_requests_total{job="api"}[30m]))
      - record: job:slo_errors_per_request:ratio_rate1h
        expr: |
          sum by (job) (rate(http_requests_total{job="api", code=~"5.."}[1h]))
          /
          sum by (job) (rate(http_requests_total{job="api"}[1h]))
      - record: job:slo_errors_per_request:ratio_rate6h
        expr: |
          sum by (job) (rate(http_requests_total{job="api", code=~"5.."}[6h]))
          /
          sum by (job) (rate(http_requests_total{job="api"}[6h]))

      # SLO 99,9 % : budget d'erreur = 0,1 % des requêtes
      # Consommation rapide : 2 % du budget mensuel en 1 h (taux de consommation 14,4)
      - alert: BudgetErreurConsommationRapide
        expr: |
          job:slo_errors_per_request:ratio_rate1h > (14.4 * 0.001)
          and
          job:slo_errors_per_request:ratio_rate5m > (14.4 * 0.001)
        labels:
          severity: page
      # Consommation soutenue : 5 % du budget mensuel en 6 h (taux de consommation 6)
      - alert: BudgetErreurConsommationSoutenue
        expr: |
          job:slo_errors_per_request:ratio_rate6h > (6 * 0.001)
          and
          job:slo_errors_per_request:ratio_rate30m > (6 * 0.001)
        labels:
          severity: page
Les règles d'enregistrement calculent chaque ratio une fois, pour les alertes comme pour les tableaux de bord ; sum by (job) fait porter le SLI sur le service, pas sur un pod ; le seuil vaut taux de consommation × budget. Avec 2 % d'erreurs pendant une heure, le test déclenche l'alerte rapide ; avec 0,05 %, rien.
Dans Kubernetes, le compteur peut venir de l'application ou du point d'entrée du cluster, plus proche de l'utilisateur ; une sonde externe couvre les pannes qui empêchent toute requête d'arriver.
Erreurs fréquentes
Le SLO est tenu, les utilisateurs se plaignent
Symptôme. 99,95 % de réussite au tableau de bord, des plaintes de lenteur au support. Cause. Le SLI ne mesure que la disponibilité, ou la latence en moyenne, qui masque les requêtes lentes. Correction. Ajoutez un SLI de latence en part des requêtes sous un seuil (« 99 % en moins de 300 ms »), mesuré au plus près de l'utilisateur.
L'alerte réveille l'astreinte pour un pic de deux minutes
Symptôme. Des pages nocturnes qui se résolvent seules. Cause. L'alerte compare le taux d'erreur instantané au budget, sans notion de vitesse. Correction. Alertez sur le taux de consommation, avec une fenêtre longue et une courte.
Aucune alerte quand le service ne reçoit plus de trafic
Symptôme. Service inaccessible la nuit, aucune alerte. Cause. Sans requête, le ratio vaut 0 ÷ 0 : PromQL renvoie NaN, et toute comparaison avec NaN est fausse. Correction. Une sonde externe, ou une alerte sur l'absence de trafic attendu.
Le budget est épuisé et rien ne change
Symptôme. Le SLO est raté trois mois de suite, les livraisons continuent. Cause. Aucune politique de budget validée. Correction. Écrivez-la avant d'en avoir besoin, et faites-la valider par ceux qui décident des priorités.
Attention
Un SLO fixé au niveau actuel du service fige l'existant. Partez du besoin de l'utilisateur, puis vérifiez que le service peut le tenir.
Aide-mémoire
- SLI = événements bons ÷ événements valides, mesuré côté utilisateur.
- SLO = cible sur un SLI, sur 30 jours glissants par défaut ; SLA = contrat, moins exigeant.
- Budget d'erreur = 1 − SLO ; 99,9 % sur 30 jours ≈ 43 minutes.
- Taux de consommation : 1 = budget épuisé en fin de fenêtre.
- Alertes : 14,4 sur 1 h et 5 min ; 6 sur 6 h et 30 min ; 1 sur 3 jours et 6 h (ticket).
- Seuil = taux de consommation × (1 − SLO).
- Latence : en part des requêtes sous un seuil, jamais en moyenne.
- Trafic nul : ratio
NaN, prévoir une sonde externe. - DORA : vitesse et stabilité des livraisons ; SLO : promesse tenue.
Pour aller plus loin
- SRE en 2026 : la pile de compétences à maîtriser, sur ce blog.
- Service Level Objectives, livre SRE de Google.
- Implementing SLOs et Alerting on SLOs, SRE Workbook.
- Métriques DORA.
- Règles d'enregistrement et tests unitaires des règles, Prometheus.
- OpenSLO.
Vos équipes débattent de la fiabilité à chaque incident ? Définissons ensemble vos objectifs de service.