Thème : SRE : fiabilité & performance
SRE en 2026 : la pile de compétences à maîtriser
Sept familles de compétences font un Site Reliability Engineer, et aucune ne se résume à un outil. Cet article les définit, les distingue des notions voisines et vous aide à choisir celles à travailler en premier.
En bref
À l'issue de cet article, vous saurez :
- distinguer le SRE de l'exploitation classique et du DevOps ;
- identifier les sept familles de compétences d'un SRE en 2026 ;
- évaluer votre niveau, ou celui d'une équipe, sur chacune d'elles ;
- choisir les deux compétences à travailler en priorité selon votre contexte.
Si vous ne deviez retenir que trois choses :
- Le SRE traite l'exploitation comme un problème d'ingénierie logicielle, mesuré par des objectifs de service.
- Les outils changent tous les deux ou trois ans ; les fondamentaux et les objectifs de service restent.
- En 2026, Kubernetes et l'IA générative élargissent le terrain du SRE sans changer sa méthode.
Contexte
Le titre de SRE recouvre aujourd'hui des réalités très différentes : une équipe d'astreinte renommée, une équipe plateforme qui maintient Kubernetes, ou une fonction qui négocie avec les développeurs le niveau de fiabilité d'un service. Ces postes ne demandent pas les mêmes compétences, et les confondre mène à des recrutements ratés.
La définition d'origine, posée par Google dans Site Reliability Engineering (2016), est plus exigeante : confier l'exploitation à des ingénieurs qui la traitent comme un problème logiciel, avec un plafond de travail répétitif et des objectifs de fiabilité explicites. Depuis, Kubernetes est devenu le socle d'exécution par défaut, l'observabilité s'est normalisée autour d'OpenTelemetry, et l'IA générative s'est invitée dans l'analyse d'incidents, avec un coût à piloter. La question n'est donc plus « quels outils apprendre ? », mais « quelles compétences restent vraies quand les outils changent ? ».
Concepts clés
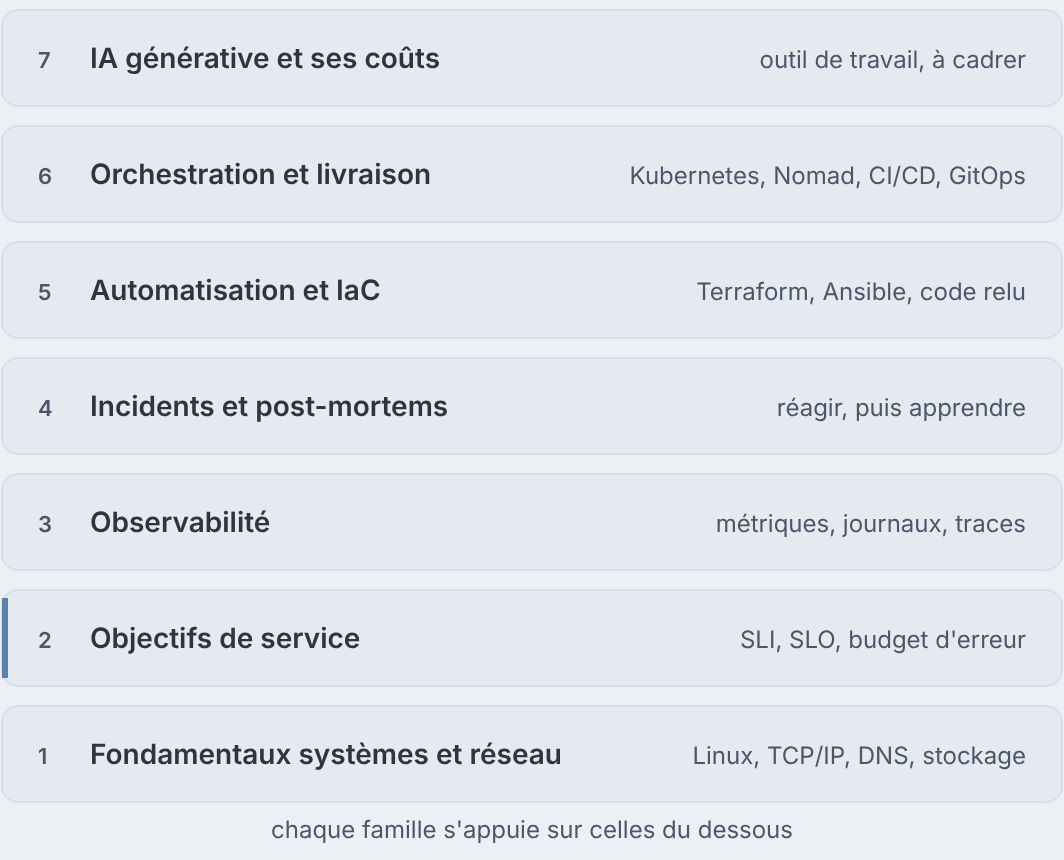
Les sept familles s'empilent, chacune s'appuyant sur celles du dessous. Un SRE peut être expert sur deux ou trois d'entre elles, mais doit savoir lire les sept.
Fondamentaux systèmes et réseau
Tout commence sous l'abstraction : processus, mémoire, entrées-sorties, TCP/IP, DNS, TLS. Savoir lancer une commande ne suffit pas, il faut savoir ce qu'elle mesure. Une latence qui grimpe sans hausse de charge vient souvent d'un DNS lent ou d'un disque saturé, que le tableau de bord applicatif ne montre pas. C'est la famille qui raccourcit les diagnostics, et elle ne se périme pas.
Objectifs de service (SLI, SLO, budget d'erreur)
Le SLI mesure ce que perçoit l'utilisateur, le SLO fixe la cible, le budget d'erreur l'écart permis : à 99,9 % sur 30 jours, environ 43 minutes d'indisponibilité. Rien à voir avec un SLA, engagement contractuel, ni avec un objectif de 100 %, que le livre SRE déconseille. Tant qu'il reste du budget, on livre ; sinon, la fiabilité passe devant. La fiabilité devient une décision partagée.
Observabilité
Observer, c'est pouvoir répondre à une question imprévue à partir des métriques, journaux et traces, les signaux distincts d'OpenTelemetry. La supervision vérifie des états connus ; l'observabilité sert à comprendre le reste. Les quatre signaux dorés (latence, trafic, erreurs, saturation) suffisent pour la plupart des services, et un standard ouvert évite de réécrire la collecte à chaque changement d'outil.
Incidents et post-mortems
Un incident se gère avec des rôles clairs : coordination, opérations, communication. L'astreinte n'est que le dispositif qui vous réveille. Le post-mortem sans reproche cherche ensuite les causes dans le système, pas chez les personnes, et se termine par des actions correctives datées et suivies. C'est ce qui fait reculer les incidents récurrents.
Automatisation et Infrastructure as Code
L'infrastructure se décrit dans du code versionné et relu (Terraform pour les ressources, Ansible pour la configuration), et le travail répétitif, le toil du livre SRE, reste sous la moitié du temps d'un ingénieur. Un script non versionné ne règle rien, il déplace le problème. Un changement d'infrastructure passe en revue de code, comme un changement applicatif.
Orchestration et livraison
Il faut maîtriser le socle d'exécution, Kubernetes ou Nomad, et la chaîne qui y livre, de la CI/CD au GitOps, où un agent applique en continu l'état décrit dans Git. Inutile de savoir reconstruire un plan de contrôle ; indispensable de comprendre pourquoi un déploiement n'a pas redémarré ses pods. Dans Kubernetes, la fiabilité se déclare (sondes, ressources, budgets d'interruption, mise à l'échelle), et une déclaration incomplète est exécutée fidèlement.
IA générative et ses coûts
Les agents analysent des journaux, rédigent un premier jet de post-mortem ou de module d'infrastructure. Ils proposent, sans rien garantir : leur production se relit comme le code d'un collègue. Résumer les journaux d'un incident fait gagner du temps ; appliquer seul une correction en production en fait perdre. La compétence nouvelle consiste à suivre ce que coûte cette assistance, en tokens ou en GPU.
Référence rapide
L'univers Kubernetes vu par un SRE
| Mécanisme | Rôle pour la fiabilité | Question à se poser |
|---|---|---|
Sondes livenessProbe, readinessProbe, startupProbe |
Redémarrer un conteneur bloqué, retirer du trafic un pod pas prêt, laisser démarrer un service lent | Chaque sonde teste-t-elle ce qu'elle prétend tester ? |
| Demandes et limites de ressources | Placement des pods et protection des voisins | Les valeurs viennent-elles d'une mesure ou d'une copie ? |
PodDisruptionBudget |
Garder un minimum de répliques pendant une maintenance | Une mise à jour des nœuds peut-elle couper le service ? |
HorizontalPodAutoscaler |
Ajuster le nombre de répliques à la charge | Sur quelle métrique, et avec quelle marge ? |
| Contrôleurs GitOps (Argo CD, Flux) | Réconcilier en continu le cluster avec Git | Qui peut modifier le cluster sans passer par Git ? |
| Cycle de versions | Trois versions par an, environ 14 mois de correctifs chacune | Le cluster est-il encore dans la fenêtre de support ? |
Critère de décision
Pour choisir les deux familles à travailler en premier, partez de la dernière douleur réelle. Incidents récurrents : incidents et observabilité. Arbitrages sans fin entre livraison et stabilité : objectifs de service. Semaine absorbée par des tâches manuelles : automatisation. Migration vers Kubernetes en cours : orchestration, sans négliger les fondamentaux.
Idées reçues
- « Le SRE, c'est l'exploitation sous un autre nom. » Le livre SRE plafonne au contraire le travail répétitif pour que le reste du temps aille à l'ingénierie. Une équipe qui ne fait que de l'exploitation n'a que le titre.
- « L'objectif, c'est 100 % de disponibilité. » Au-delà d'un certain seuil, l'utilisateur ne perçoit plus la différence, et chaque neuf supplémentaire ralentit les livraisons. Viser 100 %, c'est ne jamais avoir de budget pour livrer.
- « Kubernetes rend les services fiables. » Il exécute ce qu'on lui déclare : une sonde mal écrite ou des ressources copiées d'un autre service produisent des redémarrages en boucle, eux aussi très fiables.
- « Plus de tableaux de bord, c'est plus d'observabilité. » Un tableau de bord répond à une question posée à l'avance ; l'observabilité se mesure à la capacité de répondre à une question nouvelle.
Aide-mémoire
- SRE : l'exploitation traitée comme un problème d'ingénierie logicielle.
- SLI la mesure, SLO la cible, SLA le contrat, budget d'erreur 1 − SLO.
- Toil : travail manuel, répétitif, automatisable ; sous la moitié du temps.
- Quatre signaux dorés : latence, trafic, erreurs, saturation.
- Supervision : états connus ; observabilité : questions nouvelles.
- Post-mortem sans reproche : des causes dans le système, des actions suivies.
- Kubernetes : la fiabilité se déclare.
- IA générative : propose, ne décide pas ; relue, coûts suivis.
- Priorité : partir de la dernière douleur réelle.
Pour aller plus loin
- Objectifs de service : les définir, les mesurer, s'en servir, sur ce blog.
- Site Reliability Engineering et The Site Reliability Workbook, Google.
- Signaux OpenTelemetry.
- Sondes Kubernetes, budgets d'interruption et versions de Kubernetes.
- Principes OpenGitOps.
Votre équipe porte le titre de SRE sans en avoir encore les pratiques ? Parlons de la fiabilité de vos services.